

PROCESSUS · CONNAISSANCE DOCUMENTAIRE
Extraction d’informations
Des milliers de pages, une information structurée et sourcée.
Demander une démonstration Voir la présentation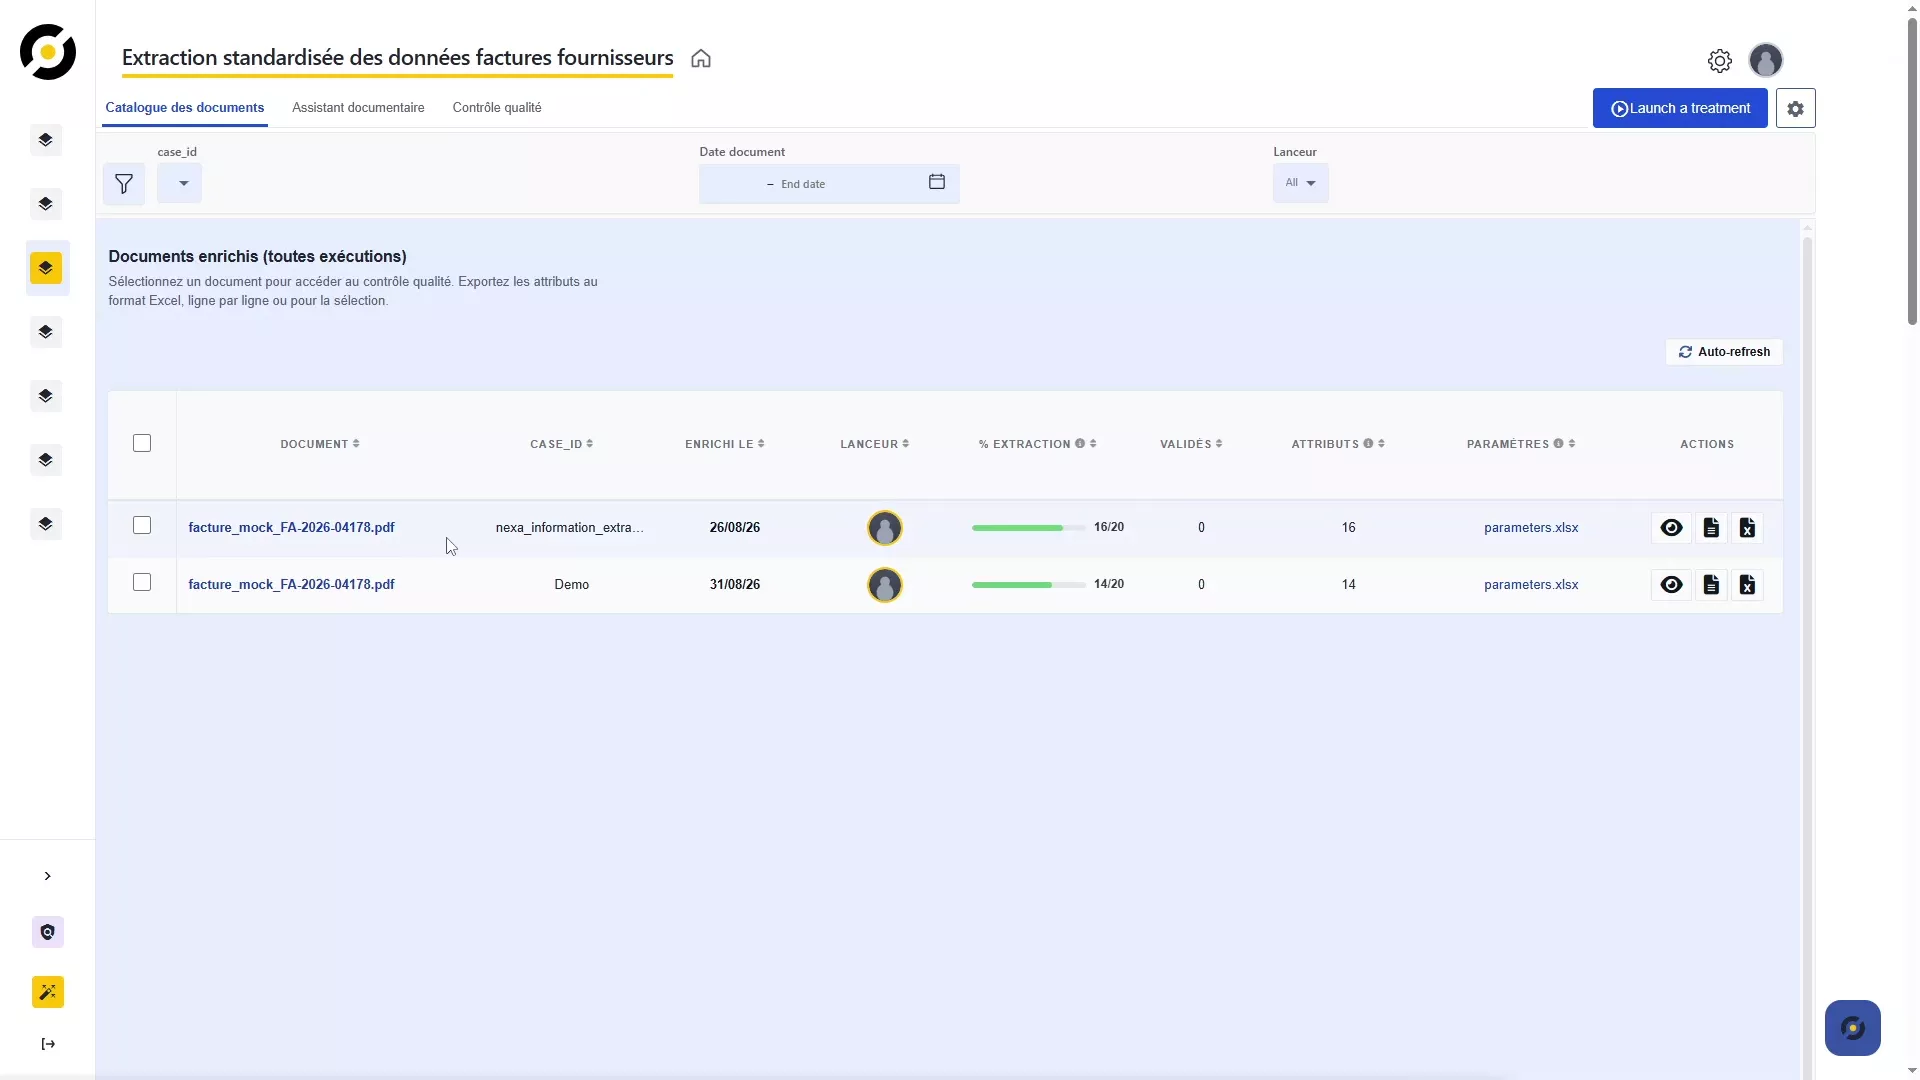
Du corpus brut à l’information exploitable : extraction, structuration, et lien systématique vers le passage d’origine.
L’impact NEXA
830
dossiers traités, plus de 11 000 pages
10 000 / 11 000
nœuds et relations extraits
80 %
de précision, hallucination proche de zéro
L’extraction d’informations transforme des corpus que personne ne peut lire en entier en données structurées et interrogeables. Chaque fait extrait reste relié à sa page d’origine : vérifiable en un clic, opposable en audit.
Les indicateurs publiés sont des ordres de grandeur mesurés en contexte client, pas des garanties contractuelles. Chaque chiffre a reçu la clearance du client concerné avant mise en ligne.
Capacités
Le volume à gauche, l’ordre à droite
Des milliers de pages hétérogènes deviennent une structure interrogeable : entités, relations, attributs. Le travail de lecture est porté par la plateforme, le jugement reste aux experts.
Chaque fait pointe vers sa source
Un fait extrait sans référence n’a pas de valeur en environnement contrôlé. Chaque élément porte le lien vers le passage exact qui le justifie, consultable sans quitter l’écran.
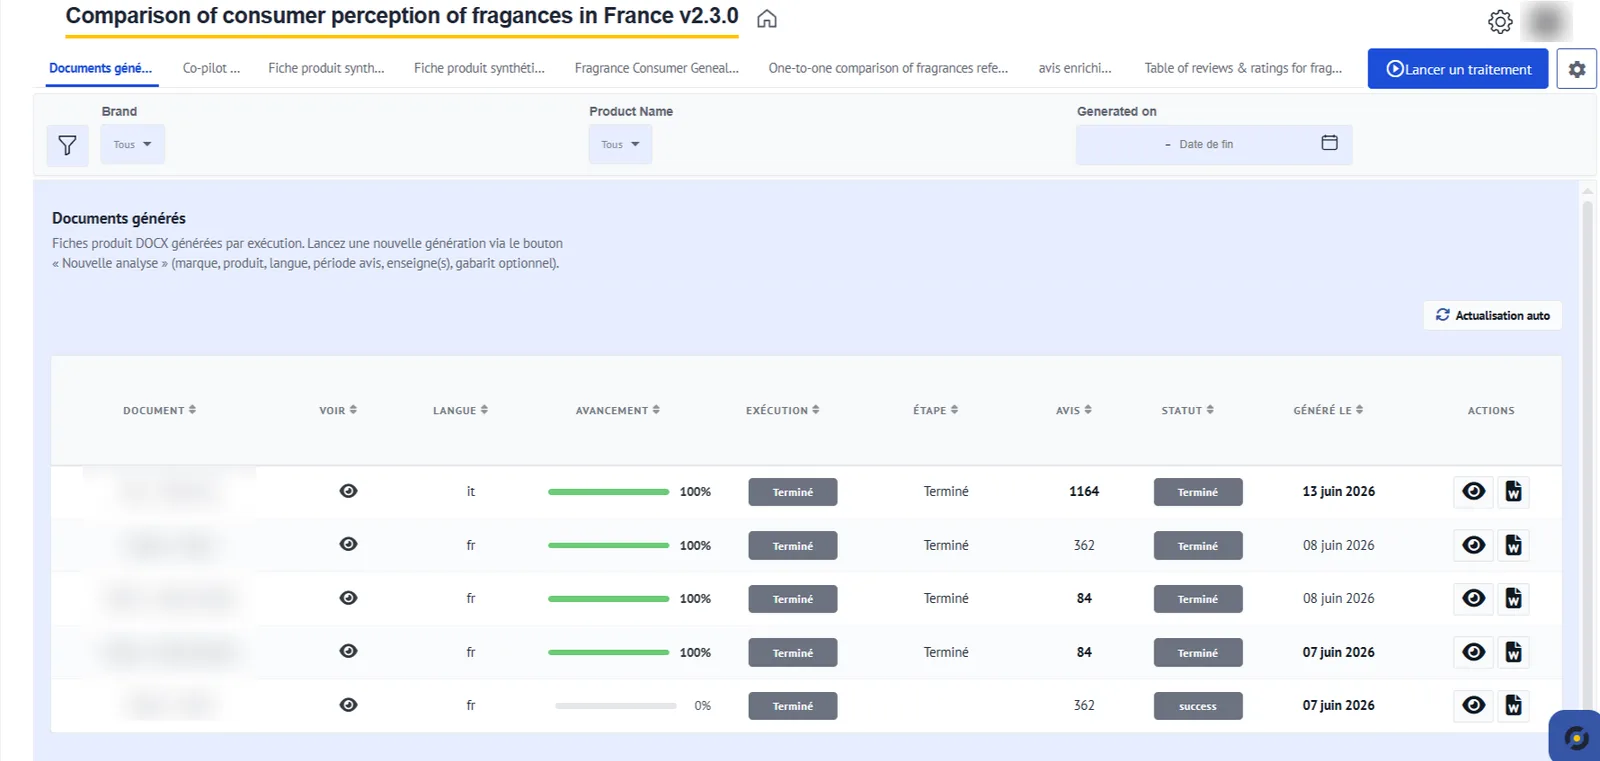
Un lineage de bout en bout
De la source au résultat, les transformations sont tracées. Un auditeur remonte la chaîne sans reconstruction manuelle.
Vue lineage : de la source au résultat, transformations comprises
Le contrôle avant la restitution
L’IA juge note l’étaiement de chaque extraction avant qu’un expert ne la voie. Les extractions faibles sont triées en tête de relecture, pas découvertes en production.
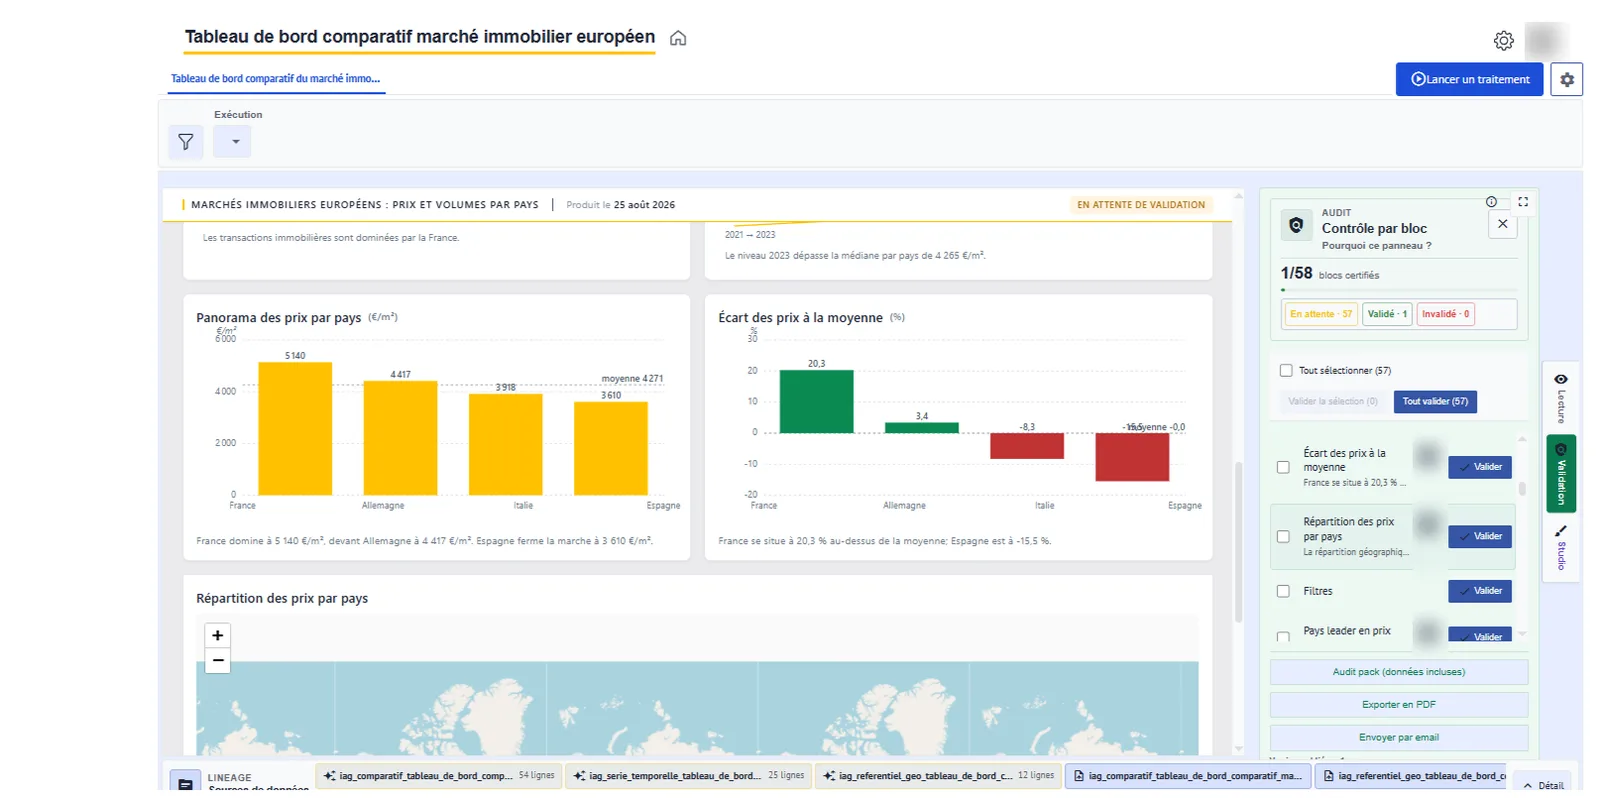
Une famille dans un portefeuille structuré.
Le déroulement du processus
Six étapes, six artefacts de preuve. C’est ce qui distingue un processus critique d’une génération de texte.
Ingestion & contexte
Sources sélectionnées, périmètre de droits appliqué, données personnelles détectées avant exécution.
Génération
Le moteur produit une proposition. Chaque assertion est reliée à sa source.
Contrôle automatique
L’IA juge note conformité, cohérence et étaiement, bloc par bloc.
Validation experte
Brouillon → Relu → Approuvé. Trois rôles séparés : opérateur, réviseur, approbateur.
Feedback gouverné
Le retour de l’expert est typé, attribué, versionné et rejoué au processus suivant.
Capitalisation
Le pattern validé sert au processus suivant, qui démarre plus vite et coûte moins cher.
Utilisateurs et données
- Utilisateurs
- Analystes risque, juristes, équipes achats, équipes stratégie
- Validateurs
- Responsable de processus, expert du domaine
- Données mobilisées
- Corpus documentaires internes et externes, dossiers, contrats, rapports
- Intégrations
- Connecteurs SI, entrepôts, export structuré
Contrôles et garde-fous
- Seuil d’étaiement configurable par processus
- Validation désactivée quand la preuve est insuffisante
- Détection des données personnelles avant exécution
- Contrat de colonnes vérifié : écart = rejet
- Exécution rejouable à la demande d’un auditeur
- Dossier d’audit exportable sur la période choisie
Ce que ce processus laisse comme trace
Transparence
Ce que ce processus laisse comme trace
Reçu d’exécution, tableau de preuves dans l’interface, dossier d’audit exportable et rejeu à la demande.
Voir la chaîne de preuve →Gouvernance
Ce que ce processus consomme et rapporte
Coût par exécution, jetons, empreinte CO₂, nombre d’utilisations, taux d’acceptation et ROI configuré par le responsable du processus.
Voir le Cockpit →Simulateur ROI
Ce que coûte et rapporte un parc de processus
Comparez les trois voies sur vos volumes, puis simulez ce qu’un processus rapporte : point d’équilibre, natures de valeur, Cost per Run.
Ouvrir le simulateur →Passez ce processus en production.
Une démonstration sur vos propres documents, pas sur un jeu de données de démonstration.